

Chiunque gestisca un’infrastruttura aziendale sa quanto la posta elettronica sia, ancora oggi, uno dei servizi più critici da tenere in piedi.
Notifiche di backup, alert di monitoraggio, invii applicativi, comunicazioni interne: se lo smarthost SMTP che inoltra questo traffico va giù, il problema spesso non si nota subito, ma quando emerge è già tardi — un job di backup fallito senza preavviso, un allarme di sicurezza mai recapitato.
Postfix è da anni la scelta di riferimento per costruire un relay SMTP affidabile, leggero e facilmente configurabile, ma da solo resta comunque un singolo punto di guasto: se il server che lo ospita si ferma, tutta la posta in transito rimane bloccata finché non si interviene manualmente.
La soluzione più naturale, e anche una delle più economiche in termini di risorse, è affiancare a Postfix un meccanismo di failover automatico che sposti l’IP virtuale del servizio su un nodo di backup senza intervento umano.
In questa guida vedremo come installare e configurare due nodi Postfix identici in ruolo di smarthost, e come metterli in alta affidabilità usando KeepAlived e il protocollo VRRP per gestire l’IP virtuale condiviso.
Al termine avrai un’infrastruttura di relay SMTP che sopravvive al riavvio o al guasto di uno dei due nodi, senza che le applicazioni a monte debbano nemmeno accorgersene.
ARCHITETTURA
Come si ottiene il failover senza toccare i client
Sì, si può fare, ed è uno scenario molto comune. La chiave è che i client non parlano mai direttamente a postfix1 o postfix2: parlano sempre a un unico nome DNS (smtp-relay.azienda.local) che risolve verso un indirizzo IP virtuale (VIP).
Quell’indirizzo, in ogni istante, è ospitato fisicamente da uno solo dei due nodi.
keepalived, tramite il protocollo VRRP, sposta la VIP da un nodo all’altro in caso di guasto, in genere in 1-3 secondi, senza che nulla vada riconfigurato lato client o lato DNS.
Perché funzioni tra due reti fisicamente diverse serve un accorgimento: i due nodi devono condividere un segmento di livello 2 (la stessa VLAN/subnet) su cui far vivere la VIP e scambiarsi l'”heartbeat” VRRP.
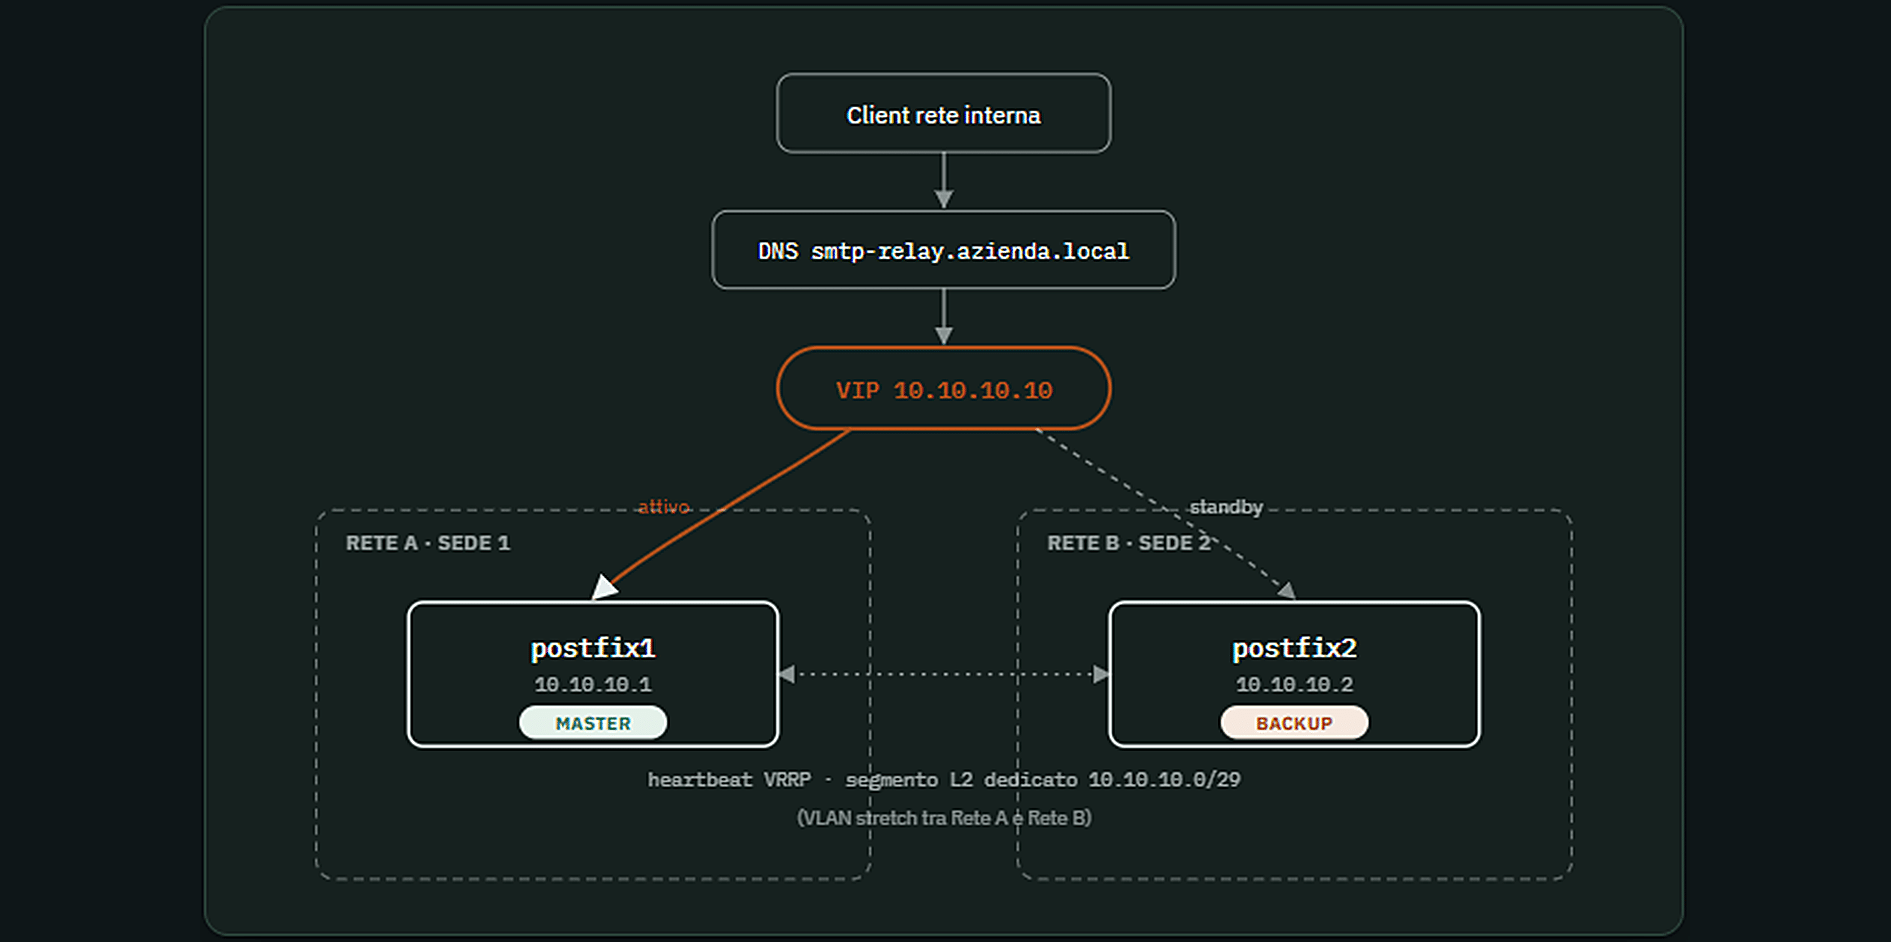
Il client si affida sempre allo stesso nome DNS e allo stesso IP virtuale. È keepalived, tramite VRRP sul segmento L2 dedicato che collega le due reti, a spostare la VIP dal nodo attivo a quello di standby in caso di guasto senza che DNS o client vengano toccati.
PREREQUISITI
Prima di iniziare servono:
- Due host (fisici o VM), uno per rete/sede, con una distribuzione Ubuntu Server 26.04
- Un segmento L2 dedicato esteso tra le due reti (VLAN stretch, trunk dedicato o overlay tipo VXLAN gestito dal team di rete), anche una subnet piccola basta (negli esempi 10.10.10.0/29).
- Un nome DNS interno per lo smarthost, es. smtp-relay.azienda.local, che punterà alla VIP.
- Accesso root su entrambi i nodi.
- Le subnet delle reti client che dovranno essere autorizzate a inoltrare posta (per mynetworks).
- Se lo smarthost deve a sua volta inoltrare la posta verso un relay esterno (provider anti-spam, Microsoft 365, SES, ecc.), le relative credenziali/host in questa guida: una casella email esistente (indirizzo completo e password) da usare solo per l’autenticazione SMTP in uscita.
RIFERIMENTO
Schema IP usato in questo tutorial
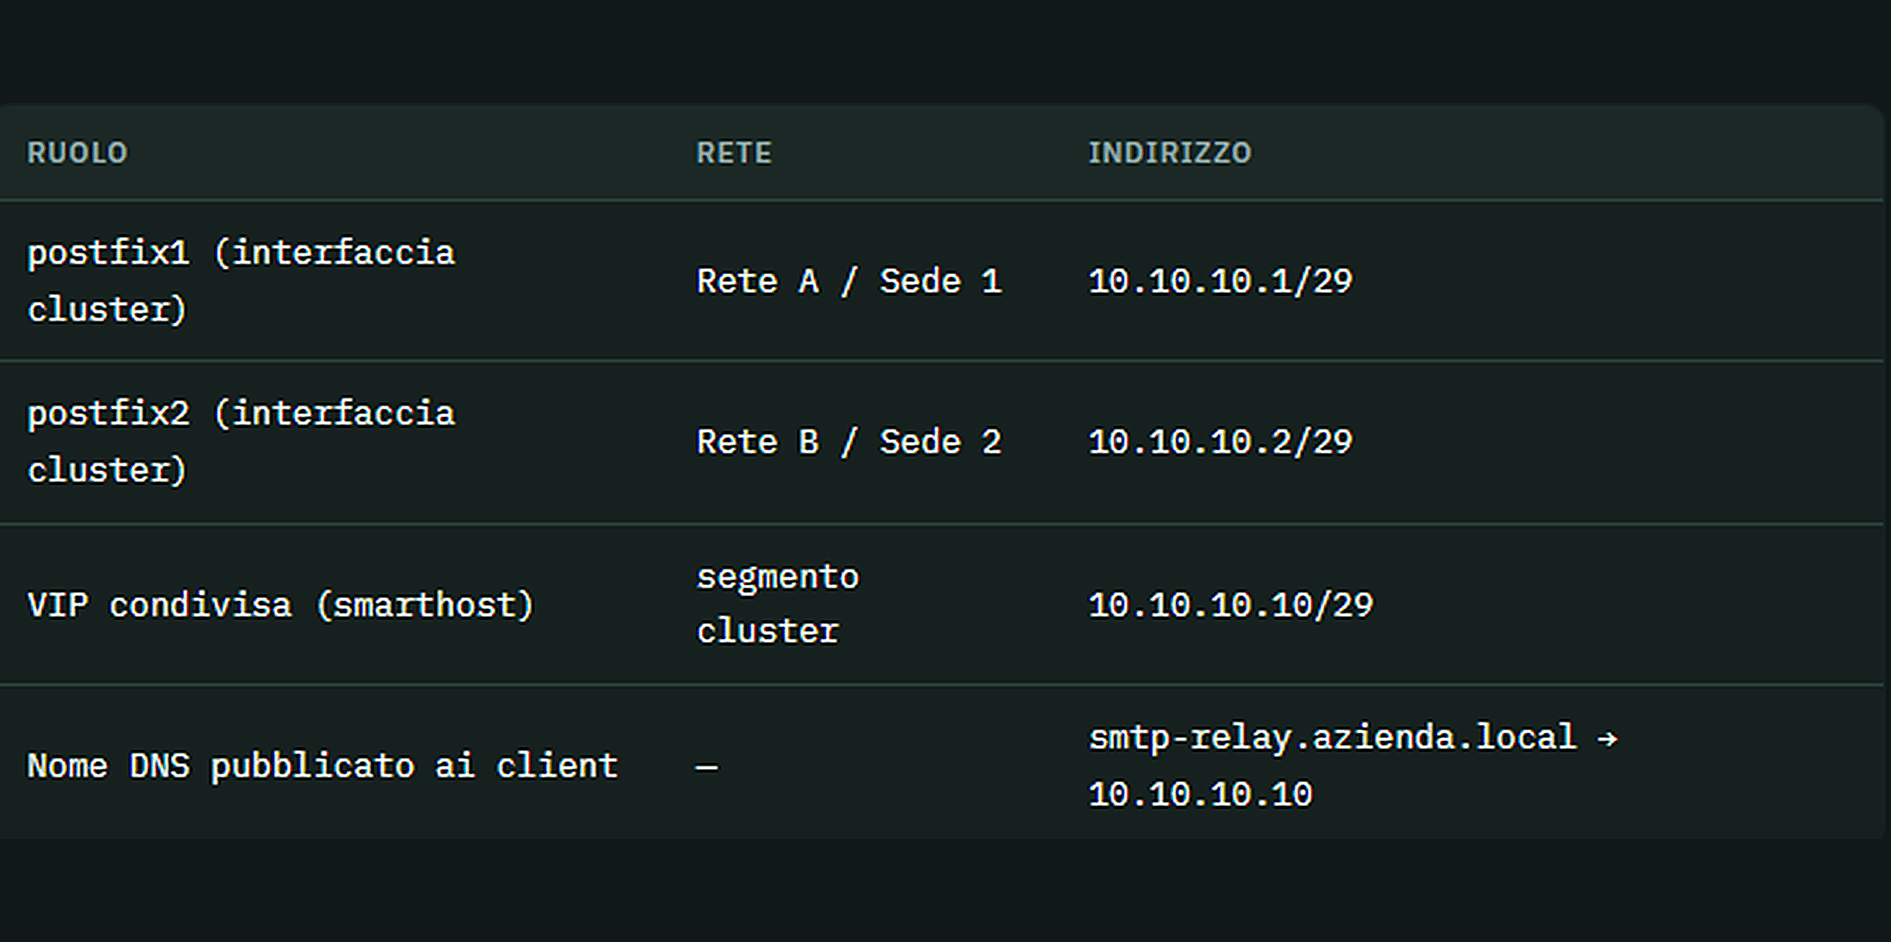
ATTENZIONE: Sostituire questi valori con i tuoi.
I due nodi mantengono anche il proprio indirizzo “normale” sulla rete A/B per la gestione ordinaria (SSH, monitoring): l’interfaccia sul segmento 10.10.10.0/29 è dedicata esclusivamente al cluster.
PREPARAZIONE DELLA RETE
Prima di toccare i server, va predisposto il segmento su cui vivrà la VIP.
Chiedi al team di rete di estendere una VLAN dedicata (o un overlay L2) tra le due sedi/reti, riservata al cluster, non serve che sia grande, basta un /29 o /28.
Verifica se il link tra le due sedi inoltra correttamente il traffico multicast: su collegamenti WAN-like tra sedi spesso no.
In questa guida configuriamo comunque VRRP in modalità unicast, che non dipende dal multicast ed è la scelta più robusta per questo scenario.
Aprire sui firewall intermedi il protocollo VRRP (IP protocol 112) tra i due indirizzi cluster (10.10.10.1 ↔ 10.10.10.2).
Verificare che la latenza tra le due sedi sul link cluster sia bassa e stabile: latenze alte o instabili causano falsi failover.
Creare il record DNS smtp-relay.azienda.local → 10.10.10.10.
INSTALLAZIONE DI POSTIFIX SU UBUNTU 26.04
Ripetere questi passaggi su entrambi i nodi.
Impostare prima l’hostname corretto: Postfix lo legge in fase di installazione per proporre il “system mail name”, e usarlo da subito evita di doverlo correggere dopo.
Sul server Postfix 1 eseguire il comando:
|
0 |
hostnamectl set-hostname postfix1.azienda.local
|
Sul server Postfix 2 eseguire il comando:
|
0 |
hostnamectl set-hostname postfix2.azienda.local
|
Verificare che /etc/hosts risolva l’hostname localmente (Ubuntu lo fa già in automatico con la riga 127.0.1.1), poi aggiorna il sistema e preconfigura le risposte debconf di Postfix per un’installazione non interattiva e ripetibile in modo identico sui due nodi.
Sul Server Postfix 1 e Postfix 2 eseguire i comandi:
|
0
1
2
3
4
5
6
|
apt update && apt upgrade -y
echo "postfix postfix/main_mailer_type select Internet Site" | debconf-set-selections
echo "postfix postfix/mailname string smtp-relay.azienda.local" | debconf-set-selections
DEBIAN_FRONTEND=noninteractive apt install -y postfix libsasl2-modules keepalived
|
libsasl2-modules non è strettamente necessario per il ruolo di smarthost verso i client interni, ma serve al passo 4 per autenticarsi in uscita verso il Mail Server Esterno con i meccanismi PLAIN/LOGIN. Al termine dell’installazione Postfix è già attivo con una configurazione minima: il passo successivo la sostituisce.
CONFIGURAZIONE BASE DI POSTFIX
Questa configurazione deve essere identica su entrambi i nodi (a parte l’hostname, se vuoi differenziarlo).
Il punto chiave è inet_interfaces = all: Postfix ascolta su tutte le interfacce del nodo, quindi non serve riavviarlo quando la VIP arriva o se ne va.
Editare sul server Postfix 1 e postfix 2 il file /etc/postfix/main.cf con il comando:
|
0 |
sudo nano /etc/postfix/main.cf
|
Quindi incollare all’interno il seguente output:
|
0
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
|
myhostname = smtp-relay.azienda.local
mydomain = azienda.local
myorigin = $mydomain
# ascolta su tutte le interfacce: fisica + VIP, indifferentemente
inet_interfaces = all
inet_protocols = ipv4
mydestination = localhost
# reti autorizzate a usare questo smarthost per il relay
mynetworks = 127.0.0.0/8, 10.10.10.0/29, <RETE_A>/24, <RETE_B>/24, <ALTRE_RETI_CLIENT>/24
# è un puro relay in uscita: non consegna localmente per altri domini
relay_domains =
smtpd_relay_restrictions = permit_mynetworks, reject_unauth_destination
# il relay esterno (relayhost + SASL) è configurato successivamente
smtpd_tls_security_level = may
smtp_tls_security_level = may
smtpd_tls_cert_file = /etc/ssl/certs/smtp-relay.pem
smtpd_tls_key_file = /etc/ssl/private/smtp-relay.key
message_size_limit = 26214400
|
Applicare e ricaricare il server Postfix 1 e postfix 2 con i seguenti comandi:
|
0
1
2
|
postfix check
systemctl restart postfix
|
CONFIGURAZIONE RELAY AUTENTICATO
Invece di consegnare direttamente via MX, in questo tutorial inoltriamo a entrambi i nodi tutta la posta in uscita attraverso il server SMTP Pubblico, autenticandosi con una casella email già esistente (dedicata solo a questo scopo, non usata per leggere posta).
ATTENZIONE: La maggior parte dei gestori di posta applicano limiti al numero di messaggi inviabili per casella/giorno, pensati per un uso da client di posta, non da relay aziendale. Se il volume di posta di tutta la rete interna passa da qui, verifica con il fornitore di posta i limiti del tuo piano prima di andare in produzione: superarli comporta email rifiutate o accodate, non un errore visibile ai client interni.
Modificare il file main.cf, su entrambi i nodi con il comando:
|
0 |
sudo nano /etc/postfix/main.cf
|
Quindi aggiungere il seguente output:
|
0
1
2
3
4
5
6
7
8
|
relayhost = [smtps.aruba.it]:465
smtp_tls_wrappermode = yes
smtp_tls_security_level = encrypt
smtp_tls_CAfile = /etc/ssl/certs/ca-certificates.crt
smtp_sasl_auth_enable = yes
smtp_sasl_password_maps = hash:/etc/postfix/sasl_passwd
smtp_sasl_security_options = noanonymous
smtp_sasl_mechanism_filter = plain, login
|
Creare il file con le credenziali della casella Mail e trasformalo nella mappa che Postfix usa per cercarle (va rifatto ogni volta che il file cambia).
Ovviamante è da fare su entrambe i Server Postfix 1 e Postfix 2
Eseguire il comando:
|
0 |
sudo nano /etc/postfix/sasl_passwd
|
Quindi incollare il seguente output:
|
0 |
[smtps.test.it]:465 nomecasella@tuodominio.it:PasswordDellaCasella
|
Salvare e chiudere il file di configurazione
Quindi eseguire i comandi:
|
0
1
2
3
4
5
6
|
postmap /etc/postfix/sasl_passwd
chown root:root /etc/postfix/sasl_passwd /etc/postfix/sasl_passwd.db
chmod 600 /etc/postfix/sasl_passwd /etc/postfix/sasl_passwd.db
systemctl restart postfix
|
Verificare che l’autenticazione funzioni inviando un messaggio di prova e controllando il log con i seguenti comandi:
|
0
1
2
|
echo "corpo del messaggio" | mail -s "test relay Aruba" destinatario@dominio-esterno.tld
tail -f /var/log/mail.log
|
Nel log, una consegna riuscita verso il mail server pubblico mostra una riga relay=smtps.test.it[…]:465, … status=sent; un problema di credenziali compare invece come SASL authentication failed.
SINCRONIZZAZIONE DELLA CONFIGURAZIONE TRA I NODI
Il rischio più comune in un cluster attivo/passivo è il drift: i due nodi si scollegano nel tempo perché una modifica viene fatta solo su uno dei due, e il giorno del failover il nodo di riserva si comporta diversamente.
Di seguito alcune opzioni, dalla più semplice alla più solida da implementare:
Repository git + deploy manuale: tieni main.cf/master.cf in un repository, applichi le modifiche su un nodo, apri una PR/commit, poi esegui lo stesso file sull’altro nodo.
rsync a senso unico con verifica: uno script che confronta i due file e segnala differenze prima di ogni modifica pianificata.
Ansible (consigliato se hai già altra infrastruttura gestita così): un playbook con un unico template main.cf.j2 applicato a entrambi i nodi garantisce che siano sempre identici per costruzione.
CONFIGURAZIONE DI KEEPALIVED
Keepalived gira su entrambi i nodi con lo stesso virtual_router_id, ma priorità diverse: il nodo con priorità più alta diventa MASTER e prende la VIP; l’altro resta BACKUP finché non rileva l’assenza degli annunci VRRP del master.
Un dettaglio importante: non basta che il processo keepalived sia vivo, deve esserlo anche postfix.
Per questo aggiungere uno script di controllo (vrrp_script) che verifica che Postfix sia realmente in ascolto sulla porta 25: se fallisce, la priorità del nodo viene abbassata e la VIP migra automaticamente sull’altro nodo anche se il sistema operativo è ancora “vivo”.
Su entrambe i server creare il file check_postfix.sh con il comando:
|
0 |
sudo nano /usr/local/bin/check_postfix.sh
|
Quindi incollare il seguente output:
|
0
1
2
3
4
5
|
#!/bin/bash
# esce con 0 se postfix è sano, 1 altrimenti
if systemctl is-active --quiet postfix && ss -ltn | grep -q ':25 '; then
exit 0
else
exit 1
|
Salvare e chiudere lo script
Dare i permessi corretti con il comando:
|
0 |
chmod +x /usr/local/bin/check_postfix.sh
|
Sul Server Postfix 1 creare il file keepalived.conf con il comando:
|
0 |
sudo nano /etc/keepalived/keepalived.conf
|
Incollare all’interno il seguente output:
|
0
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
|
postfix1 · priorità 150
vrrp_script chk_postfix {
script "/usr/local/bin/check_postfix.sh"
interval 2
timeout 2
fall 2
rise 2
weight -20
}
vrrp_instance VI_SMTP {
interface eth1.10 # interfaccia sul segmento cluster (VLAN dedicata)
state BACKUP # BACKUP su entrambi i nodi: decide la priorità, non lo stato dichiarato
virtual_router_id 51
priority 150
advert_int 1
unicast_src_ip 10.10.10.1
unicast_peer {
10.10.10.2
}
authentication {
auth_type PASS
auth_pass CambiaQuestaPassword
}
virtual_ipaddress {
10.10.10.10/29
}
track_script {
chk_postfix
}
}
|
Salvare e chiudere il file di configurazione
Sul Server Postfix 2 creare il file keepalived.conf con il comando:
|
0 |
sudo nano /etc/keepalived/keepalived.conf
|
Incollare all’interno il seguente output:
|
0
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
|
postfix2 · priorità 100
vrrp_script chk_postfix {
script "/usr/local/bin/check_postfix.sh"
interval 2
timeout 2
fall 2
rise 2
weight -20
}
vrrp_instance VI_SMTP {
interface eth1.10
state BACKUP
virtual_router_id 51
priority 100
advert_int 1
unicast_src_ip 10.10.10.2
unicast_peer {
10.10.10.1
}
authentication {
auth_type PASS
auth_pass CambiaQuestaPassword
}
virtual_ipaddress {
10.10.10.10/29
}
track_script {
chk_postfix
}
}
|
Salvare e chiudere il file di configurazione
ATTENZIONE: virtual_router_id deve essere univoco su quel segmento L2 (0-255): se in futuro aggiungi altri cluster VRRP sulla stessa VLAN, usa ID diversi per evitare conflitti. La password di autenticazione VRRPv2 è una protezione minima contro annunci accidentali, non una misura di sicurezza forte su un segmento dedicato e isolato è comunque sufficiente.
AVVIO E VERIFICA
Su entrambe i server Postfix 1 e Postfix 2 eseguire i comandi:
|
0
1
2
|
systemctl enable --now postfix
systemctl enable --now keepalived
|
Quindi verificare che la VIP sia presente solo sul server Postfix 1 (quello con priorità più alta) con i comandi:
|
0
1
2
|
ip -4 addr show dev eth1.10 | grep 10.10.10.10
journalctl -u keepalived -n 20
|
Verificare che lo smarthost risponda sulla VIP da un client sulla rete interna con il comando:
|
0 |
telnet smtp-relay.azienda.local 25 |
Oppure per un test più completo usare il comando:
|
0
1
|
swaks --to destinatario@test.tld --from mittente@azienda.local \
--server smtp-relay.azienda.local
|
TEST DI FAILOVER
Non dare per scontato che funzioni: verificare il failover in tre modi crescenti di severità.
TEST 1 — Fermare solo Postfix (guasto applicativo)
Sul server Postfix 1 (Master) eseguire il comando:
|
0 |
systemctl stop postfix
|
Lo script di controllo dovrebbe fallire entro pochi secondi, la priorità di postfix1 scende sotto 100 e postfix2 prende la VIP.
Verificare con il comando:
|
0 |
ip -4 addr show dev eth1.10 su postfix2
|
Quindi ripetere il test SMTP dal client e se è tutto ok non dovremmo accorgerci di nulla.
TEST 2 — Isolare il nodo (guasto di rete/hardware)
Spegnere il nodo master o disabilitare la sua interfaccia cluster.
Il failover in questo caso dipende dal timeout degli annunci VRRP (circa 3 × advert_int, quindi ~3 secondi con i valori di questa guida).
TEST 3 — Failback
Riaccendere/ripristinare postfix1: avendo priorità più alta e preempt attivo (il default), riprenderà automaticamente la VIP.
Se si preferisce evitare che il nodo torni a fare da master automaticamente subito dopo un ripristino (per rivedere prima i log), aggiungere nopreempt nel blocco vrrp_instance di postfix1.
DA SAPERE
Alcuni punti che vale la pena capire prima di considerare l’infrastruttura pronta per la produzione:
Le code non sono condivise. Ogni nodo ha la propria coda di posta locale. Se un nodo accetta un messaggio e va giù prima di consegnarlo, quel messaggio resta nella sua coda finché il nodo non torna operativo. Il VIP non sposta la posta già in coda. Per uno smarthost outbound con codifica breve è normalmente accettabile, ma monitora mailq su entrambi i nodi.
mynetworks deve includere sia Rete A sia Rete B, oltre a qualunque altra subnet client autorizzata al relay altrimenti dopo un failover i client di una delle due reti potrebbero non risultare più fidati per l’altro nodo.
Le regole firewall verso i client non cambiano mai: puntano tutte alla VIP, che è sempre lo stesso indirizzo indipendentemente da quale nodo la ospita.
Monitoraggio consigliato: stato keepalived (master/backup) su entrambi i nodi, servizio postfix attivo, lunghezza della coda (mailq -p), spazio disco, log in /var/log/mail.log.
Non allargare mai mynetworks oltre le subnet realmente fidate: è l’unica barriera che impedisce che lo smarthost diventi un open relay.
smtpd_relay_restrictions = permit_mynetworks, reject_unauth_destination rifiuta esplicitamente qualunque mittente non compreso in mynetworks.
Se alcuni client non fanno parte di una rete fidata (es. workload cloud, VPN client), valutare l’aggiunta di autenticazione SASL sulla porta submission (587) invece di allargare mynetworks.
Usare certificati TLS validi (interni o Let’s Encrypt) per cifrare la sessione SMTP tra client e smarthost.
/etc/postfix/sasl_passwd contiene la password della casella di posta in chiaro: i permessi 600 impostati al passo 4 sono il minimo indispensabile. Se lo distribuisci tra i nodi tramite un repository, non versionarlo in chiaro, usare un secret manager o uno strumento tipo Ansible Vault, e valutare la rotazione periodica della password della casella.
Questa architettura richiede che le due reti possano condividere un segmento L2 per la VIP. E’ il caso confermato per il tuo scenario. Se in futuro questo non fosse più possibile (es. le due sedi passano a un collegamento puramente L3, senza alcuna possibilità di stretch), il failover trasparente via VIP condivisa non è più applicabile e le alternative diventano più complesse: DNS con più record A e retry lato client (funziona solo se i client stessi, tipicamente altri MTA, ritentano automaticamente su un secondo indirizzo), oppure anycast via BGP se l’azienda ha il controllo del routing. Entrambe richiedono più lavoro e garanzie più deboli sui tempi di failover rispetto a VRRP: vale la pena riconsiderarle solo se la premessa sulla rete cambia.




0 Commenti